Molocoは2013年から「CARA」と呼ばれるパフォーマンス広告向けのAIを構築してきました。今回はそのアプローチについて詳しくご紹介します。「CARA」は「Compound Ad Recommendation Architecture」の略称です。
Moloco Adsにおいて、CARAは「キャンペーン自動化」「サプライ」「広告レコメンデーション」「入札」「クリエイティブ」「シグナル」という6つの技術ドメインにそれぞれ特化したモデル、エージェント、専門ソフトウェアを統合的に調整する役割を担い、各ドメインは、オープンインターネット特有の課題を解決できるように設計されています。詳細についてはこちらをご覧ください。
MolocoのAIの歩み
私は20年以上にわたり、大規模なレコメンデーションシステムの構築に携わってきました。そして、その大半の時間を、私が知る限り最も困難な応用分野のひとつ、すなわちユーザーにとって関連性が高く、広告主にとって効果的な広告を配信するシステムの開発に費やしてきました。2004年、最先端の機械学習技術を大規模な実世界の問題に応用できる機会に惹かれ、博士課程を中退してGoogleに入社。同社には16年以上在籍し、最初はWeb検索、その後は研究およびパフォーマンス広告の分野に従事し、Googleで最も広く活用されている機械学習システムのいくつかを構築しました。
そこで初めて、Molocoの共同創業者兼CEOであるIkkjin Ahnと出会ったのです。2009年、YouTubeで彼が率いていたチームは、私がGoogleで少人数のチームと共に構築した機械学習プラットフォーム「Sibyl」を率先して導入しました。当時、IkkjinはYouTubeの初期の収益化システムを構築していましたが、その経験を通じて、彼はさらに大きなチャンスがあることを確信しました。それは、このように高いレベルの機械学習技術を、ウォールドガーデンを超えてパフォーマンス広告に導入することでした。彼はそのビジョンを追求するため、2013年にMolocoを設立したのです。
Googleを離れ、Snowflakeで1年以上AI部門を率いた後、私は2023年にMolocoについて詳しく調べ、3つの点に気づきました。まず、Molocoは私がキャリアを通じて見てきた中で、最も先進的なAI駆動システムのひとつを構築していたこと。次に、他社がこれを再現するのは極めて困難であること。そして、パフォーマンス広告は、より優れたAIが顧客に計測可能な価値を直接もたらし、ひいてはビジネスを強化するという、稀有な課題であるということです。
なぜMolocoのAIシステムはこれほど先進的なのか?その理由は、オープンインターネットが抱える課題が、それを必要としたからです。
オープンインターネットへのAI広告の展開は大きな技術的課題
GoogleやMetaは「ウォールドガーデン」を運営しています。ログイン済みのユーザー、確定的なID、豊富なファーストパーティのエンゲージメント履歴、そしてエンドツーエンドで管理する単一のオークションシステム。オープンインターネットには、こうした要素が何ひとつありません。
ほとんどのオークションはファーストプライス方式かつ非公開であるため、入札者は入札に関する決定を行う際や、その後も競合入札額を確認することはできません。落札できたかどうか、場合によっては落札に必要だった最低入札額が分かるだけです。多数のエクスチェンジやメディエーションプラットフォームが重複する在庫を扱っているため、手数料やその他の特性が異なる複数のルートを通じて同じインプレッションが届く可能性があります。この重複を認識せずに入札を行うことは、自分自身と競合することを意味し、結果として自社の入札価格を吊り上げてしまうことになります。このエコシステム参加者の構成も定常的ではありません。新しいエクスチェンジが参入する一方で、消滅したり統合されるエクスチェンジもあり、各エクスチェンジは、頼りにするパートナーであると同時に、入札の競合相手となることもよくあります。
私たちが構築するシステムは、数十億人のユーザー、1日あたり1兆件を超える広告機会、数千の広告主、数百万のアプリにまたがるエコシステムに対応する必要があり、決定は数十ミリ秒で行われます。ユーザー、広告主、パブリッシャー、サプライパス、クリエイティブフォーマットの組み合わせのほとんどは、これまでに一度も発生したことがないものです。これらは学習データに含まれていないため、システムは膨大な範囲にわたって一般化を行わなければなりません。そして、まさにここでモデルが誤りを犯す可能性があります。偶然をパターンと誤認(過学習)したり、パターンを完全に見逃してしまう(過小学習)ことがあるためです。
ID は断片的な形でしか存在しません。ログインユーザーに関するグラフもなければ、かなりの割合のトラフィックがデバイス識別子を含みません。システムはプロファイルを参照する代わりに、アプリ、プレースメント、地理的位置、時間、過去のイベントの連鎖といったコンテキストから一般化を行う必要があります。これらのシグナルは明確な形で届くわけではなく、異なるタイミングで、異なる形式で、異なる集計レベルで現れることもあれば、まったく現れないこともあります。
システムが予測の精度向上に利用する結果データは、得られるまでの時間も、完全性もそれぞれ異なります。購入が、アプリインストールから7日後あるいは28日後に発生したり、アトリビューションプロバイダーを経由して伝達されたり、SKAdNetworkのようなプライバシーフレームワークによって情報が集約され、ユーザーレベルの詳細情報が完全に削除されたりすることもあります。
さらに、決定は「入札するかどうか」だけに決してとどまりません。それぞれの機会において、「どの広告」「どのフォーマット」「どのクリエイティブのバリエーション」を使用するかという選択が求められ、最適な選択はユーザーやインプレッションごとに異なります。こうした決定一つひとつが数十ミリ秒で行われ、その回数は1日平均1兆回以上に及びます。¹

どの広告を推奨するか、入札額をいくらにするか、どのクリエイティブを表示するか、どのサプライパスを採用するか、そして断片的なシグナルをモデルが活用できる形にどう変換するか。これらはいずれも、それ自体が十分に重要なAI課題です。オープンなインターネットでは、これらの決定を、すべてほぼ瞬時に、同時に行わなければなりません。そして、これらすべてにおいて改善が可能なため、1つの領域での改善が他の領域に相乗効果をもたらすシステムが必要でした。
CARA:この課題のために設計された複合アーキテクチャ
こうして生まれたシステムがCARAです。CARAを構成する6つの各ドメインは、それぞれ上記の課題の1つに対応しています。例えば、「シグナル」ドメインは、断片的で遅れて届くデータを特徴量に変換し、他のすべてのCARAドメインが予測を改善するために利用できるようにします。「入札」ドメインは、リアルタイムで入札戦略を最適化します。「クリエイティブ」ドメインは、ユーザーとインプレッションごとに、表示する広告、フォーマット、クリエイティブバリエーションを最適化します。
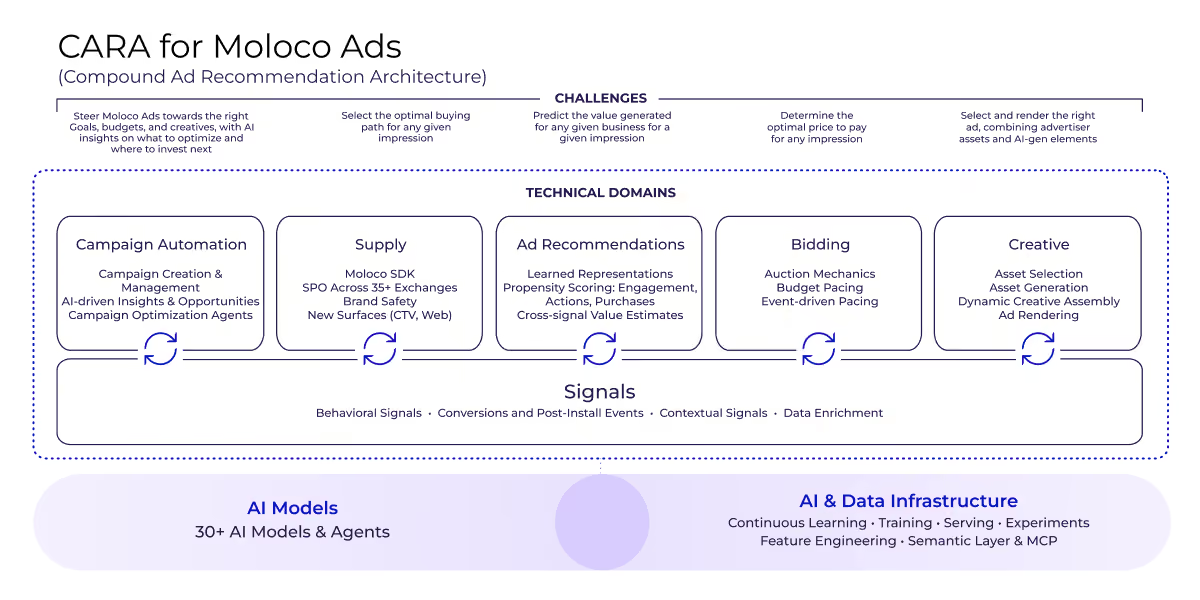
CARAの複合的なアーキテクチャにより、各ドメインは他のドメインにおける改善を活かしてより優れた決定を行うことが可能になります。ユーザーやアプリは移り変わり、クリエイティブは次第に効果が薄れ、オークションのダイナミクスも変化していくため、継続的に学習できるシステムを構築する必要がありました。
「広告レコメンデーション」のドメインを例に挙げましょう。その予測精度が向上すると、「入札」ドメインで各インプレッションの価値をより正確に推定できるようになります。この推定精度が高まると、サードパーティのエクスチェンジとMoloco独自のSDKの両方で、広告主にとって採算の合うインプレッションをより多く落札できます。落札件数が増えるほど成果データも増え、そのデータによって、このループの起点となった広告レコメンデーションを含む、システム内のすべてのドメインが再学習されます。
「クリエイティブ」ドメインについても同様です。クリエイティブの選定精度が向上することによってエンゲージメントが高まり、ユーザーの行動に関するより詳細なインサイトがトレーニングデータに反映されます。これにより、「シグナル」ドメインの表現が強化され、シーケンスモデルやマルチヘッドモデルがすべてのインタラクションから学習できるようになり、システムは行動をより深く理解できるようになります。こうした改善効果はすべてのドメインに波及し、Molocoは280万の独立したアプリ3にまたがり、1日あたり20億人以上のアクティブユーザー2 にリーチ可能な広告システムを継続的に改善しています。
可能性は無限でもパフォーマンスの維持が困難
オープンインターネットではパフォーマンス広告を改善する可能性が無限にありますが、ある分野において今日最善のアプローチが、明日も最善であるとは限りません。そのプロセスは、従来のAIのアルゴリズムである「ヒルクライミング」に似ています。これは、モデルを選び、いくつかのバリエーションを試して最良のものを選び出し、それを繰り返す手法です。初期段階では成果が急激に伸びますが、頂上に達すると伸びは頭打ちになります。つまり、多くの企業は、明らかな最適化施策をすべてやり尽くすと、そこで成長が止まってしまうのです。
継続的な改善には、登るべき新たな丘を見つける必要があり、そのためにはエンジニアリングの創造性、豊な人材、そしてチームが多数のモデルを並行して学習させ、多くのテストを並行して実行できるインフラストラクチャが求められます。以下では、これを実現できるインフラストラクチャについて、詳しく見ていきます。
基盤となるエンジン
6つのドメインすべてが同一のインフラストラクチャ上で稼働します。このインフラストラクチャには、学習、サービング、特徴量のリアルタイム抽出、テスト環境が含まれ、オープンインターネット特有の制約に対処できるように構築されています。
学習:ここでの核心的な課題は汎化能力です。システムは、まばらで、時には全く利用できないシグナルを用いて、インプレッション、広告フォーマット、ユーザー、広告主、イベント価値、クリエイティブのバリエーション、オークションパスの、これまで見たことのない組み合わせに対する結果を予測しなければなりません。Molocoでは、マルチヘッドモデル、トランスフォーマーベースのモデルを含むシーケンスモデル、ディープクロスネットワークなどのディープラーニングアーキテクチャを学習させています。シーケンスモデルは、アプリ横断的なイベント履歴から学習し、シグナルが乏しいユーザーに対しても汎化可能な豊かなユーザー表現を構築します。また、Molocoの学習プラットフォームはイベントを継続的に取り込み、求められる学習速度とコスト効率を実現するためにCPU、TPU、GPUを活用しています。新しいシグナルを取得すると、モデルを再学習し、最短で2時間ごとに本番環境にデプロイします。⁴ このシステムは、1日平均60億件以上のイベント(インプレッション、クリック、インストール、アプリ内アクション)から学習しています。⁵
サービング:高度なモデルを学習させることは、それ自体がひとつの課題であり、オークションのレイテンシ制約の中で、世界中にモデルをサービングすることはまた別の課題です。最大規模で最もコストの高いモデルは最適な表現を学習しますが、ライブトラフィックに対応できるほど高速に実行できません。そのため、これらのモデルをオフラインで実行し、知識蒸留を用いてその学習内容を軽量なモデルに圧縮します。この軽量なモデルがリアルタイムでトラフィックを処理し、新しいデータが入るたびに継続的に再学習します。現在、学習は主にTPUで行い、リアルタイム推論はGPUで実行していますが、このアーキテクチャに縛られることはありません。ハードウェアの構成は、モデルの進化に合わせて変化していきます。Googleでは、あるチームがモデルを構築した後、ハードウェアがトレーニング専用だったため、デプロイまでに数年を要した事例を目にしました。Molocoの機械学習チームは、テストとエンジニアリングを通じて、コストとパフォーマンスの最適なバランスを日々模索しています。
特徴量のリアルタイム抽出:生のシグナルは即座に特徴量に変換され、学習とサービングで一貫して計算されます。これは、学習とサービングの間に生じるずれが、本番環境のAIにとって「サイレントキラー」となり得るためです。問題は速度だけではありません。シグナルは異なるタイミングで届き、一つひとつのシグナルは不完全な情報しか提供しません。そのため、リクエストごとに、「全体像が完成するまで待ち、古くなったデータに基づいて行動する」か、「最新の不完全なデータに頼る」かのトレードオフに直面します。Molocoでは、ユーザーに関する履歴データに基づく理解と、最新のアクティビティから得られる情報を組み合わせて予測を行います。これには、高度なキャッシュ処理と特徴量のリアルタイム管理が不可欠です。
テスト:常により優れたモデルが存在します。理論上、ディープラーニングはあらゆる関数を近似できます。しかし、「ノーフリーランチ定理」によると、万能な学習アルゴリズムは存在しません。つまり、考えられるすべての問題について平均すると、どのアプローチも同じ性能になります。あるモデルが他のモデルよりも優れた性能を発揮できるのは、その仮定が目の前の問題に適合した場合だけです。こうした仮定は「帰納バイアス」と呼ばれ、そこにドメインの専門知識が宿ります。理論から正しい仮定を導き出す方法はないため、Molocoでは、パフォーマンス広告に関する知見をモデルに組み込むべく、絶えず新しいモデルを学習させ、新しいアーキテクチャをテストしています。オフライン評価は本番環境でのテストに代わるものではありません。実行しなかった入札の結果を観測することは不可能なためです。Molocoでは、実トラフィックに対して100件以上のテストを同時に実施することができ⁶、互いに干渉することなく重ね合わせられるように階層化されています。また、1%未満のわずかな効果を検出できるほど精密に計測できます。テスト機能はMolocoのアーキテクチャの中核に組み込まれているため、AIで新たな課題を解決しようとする際、スタック内のほぼすべての構成をライブ環境でテストすることが可能です。
生成AIの役割
生成AIは驚異的なスピードで進化しており、こうしたイノベーションがパフォーマンス広告をどのように変革するかを考えるとワクワクします。最先端のモデルは、特定のユーザーがアプリをインストールするかどうか、また今後30日間にアプリ内でいくら課金するかを予測するCARAの能力に近いレベルまで到達しているでしょうか?答えは「ノー」です。その理由は多数あります。最先端のモデルは、広告主やエコシステムの視点からパフォーマンス広告を理解していません。ユーザーやアプリを理解するための豊富な行動シグナルも持ち合わせていません。そのため、正確に価値を予測したり、1日1兆件もの広告機会を、それぞれ数十ミリ秒以内に評価することは不可能なのです¹。
一方で、生成AIは私たちの力を大きく高めてくれます。Molocoでは、生成AIを活用してクリエイティブ要素を大規模に生成し、自然言語、画像、動画を理解しています。こうした機能により、より豊富なシグナルとより多くのアセットをCARAに提供できます。私たちが開発するモデルは、トランスフォーマー・アーキテクチャやマルチタスク学習など、生成AIの基礎研究に基づいています。また、社内ではAIエージェントを活用して業務を加速させています。キャンペーンの設定、トラブルシューティング、最適化を行う専用エージェントを開発しているほか、お客様のAIエージェントがMolocoのプロダクトと直接やり取りできるインターフェースも構築しています。
数字に見る成果と今後の課題
CARAの相乗効果は数字に表れています。2025年、Molocoは数千件に及ぶコントロールテストを実施し、Moloco Ads向けの65件のモデル改善の有効性を確認したうえで本番環境に導入しました。これら65件の改善により、Molocoの広告主は、インストール単価を14%、顧客獲得単価を17%削減し、広告費用対効果(ROAS)を27%向上させることができました。7
私は長年にわたり、「AIの第一のルールは、AIについて語らないことだ」と述べてきました。つまり、まず顧客の課題から出発し、そこからAIを応用する革新的な方法を見出すべきだと考えています。今回、私は記事全体を通してAIについて語ってきました。しかし『ファイト・クラブ』とは異なり、ここで語ってきたことはすべて現実のものであり、本番環境で稼働しています。そして、この記事が課題から始まり、その後にAIの話が続いていることから、肝心な部分で上記のルールが守られていると言えます。
私がMolocoに関して最も誇りに思うのは、個々のモデルや、その基盤となるAI・データインフラではありません。オープンインターネットにおけるパフォーマンス広告の課題をどれほど深く理解しているか、そしてそれらを解決するためにAIをテストし、適用してきた方法です。そのすべての取り組みが、「お客様に成果をもたらす」というひとつの目標の達成に貢献しています。
ユーザーに最適な商品やサービスをマッチングさせることがパフォーマンス広告の核心であり、そこには乗り越えるべき課題がほぼ無限に存在します。それこそが、私がこの仕事を愛し、20年以上にわたって続けてきた理由です。
出典
1. Moloco社内データ。2026年1月 - 3月にMoloco Adsが受信した1日あたりの平均広告機会数。数値はサンプリングされたインフラストラクチャデータを全体規模に換算して算出した推定値です。
2. 本主張におけるデイリーアクティブユーザー(DAU)は、Molocoの統合済みエクスチェンジパートナーおよび独自のSDKを通じて、世界中のAndroidおよびiOSデバイスで営業日ごとに観測された一意の消費者デバイス数の平均として定義しています。この数値は、2026年3月および4月のサンプルデータ(5営業日)の平均に基づいて、Molocoが内部推計した1日あたりの潜在的なデイリーユーザーリーチを示しています。二重計上を防ぐため、各デバイスは1つの国のみに割り当てられています。また、タブレットはエクスチェンジからのシグナルとデバイスモデルの照合による決定論的な分類に基づいて除外し、さらに国ごとのデバイス対ユーザー補正係数を適用して、デバイス数を推定ユニークユーザー数に換算しています。
3. Moloco社内データ。2026年4月3日までの90日間に、世界全体でMolocoが少なくとも1件のRTB(リアルタイム入札)リクエストを受信した、重複を除くアプリバンドルの数(iOSとAndroidの累計)。「独立系」とは、ウォールドガーデン(例:Facebook、Instagram、TikTok、Amazon Shopping、YouTubeなど)が運営していないアプリを指します。
4. Moloco ExpLabプラットフォームデータ(2025年第4四半期)。
5. Molocoの社内プラットフォームデータ。2025年1月から12月までの1日あたりの平均イベント数。
6. Moloco ExpLabのプラットフォームデータ(2025年)。
7. Molocoの社内プラットフォームデータ。2025年にリリースされたモデル更新の複合的な影響を反映。各更新は本格的に本番環境にデプロイされる前に制御されたA/Bテストを通じて検証されています。